
EmbeddingGemma 2(Google Developers Blog の解説記事より)
この仕組みの核は、音声を「文章に変換する」のではなく、音声の短い断片をテキスト埋め込み空間へ押し込み、そこから最も近い英単語を読むことにある。Hugging Face の再現実装では、40ms ごとの音声トークンを 768 次元の空間に写し、200,000 語の語彙と照合する。選び方は greedy CTC で、言語モデルは使わない。重複はまとめ、blank は落とす。かなり潔い。
この単純さが速さの理由でもある。候補を文脈込みで再構成するのではなく、各トークンの最近傍を取るだけなので、処理系の重さは一気に下がる。ただし、ここで捨てているものも多い。語順の自然さ、文脈による補正、言い直しの吸収。普通の音声認識が持っている「文として整える」力はかなり薄い。
Google の開発者ガイドが説明する EmbeddingGemma 2 は、もともと text / image / video / audio を同じ 768 次元空間で扱うモデルだ。つまり、この文字起こしは全く別の仕組みを新規に作ったのではなく、既にある位置関係を単語として読み出している。考え方としてはかなり大胆だが、同時に、埋め込みモデルが何を意味していたかを逆手に取っている。
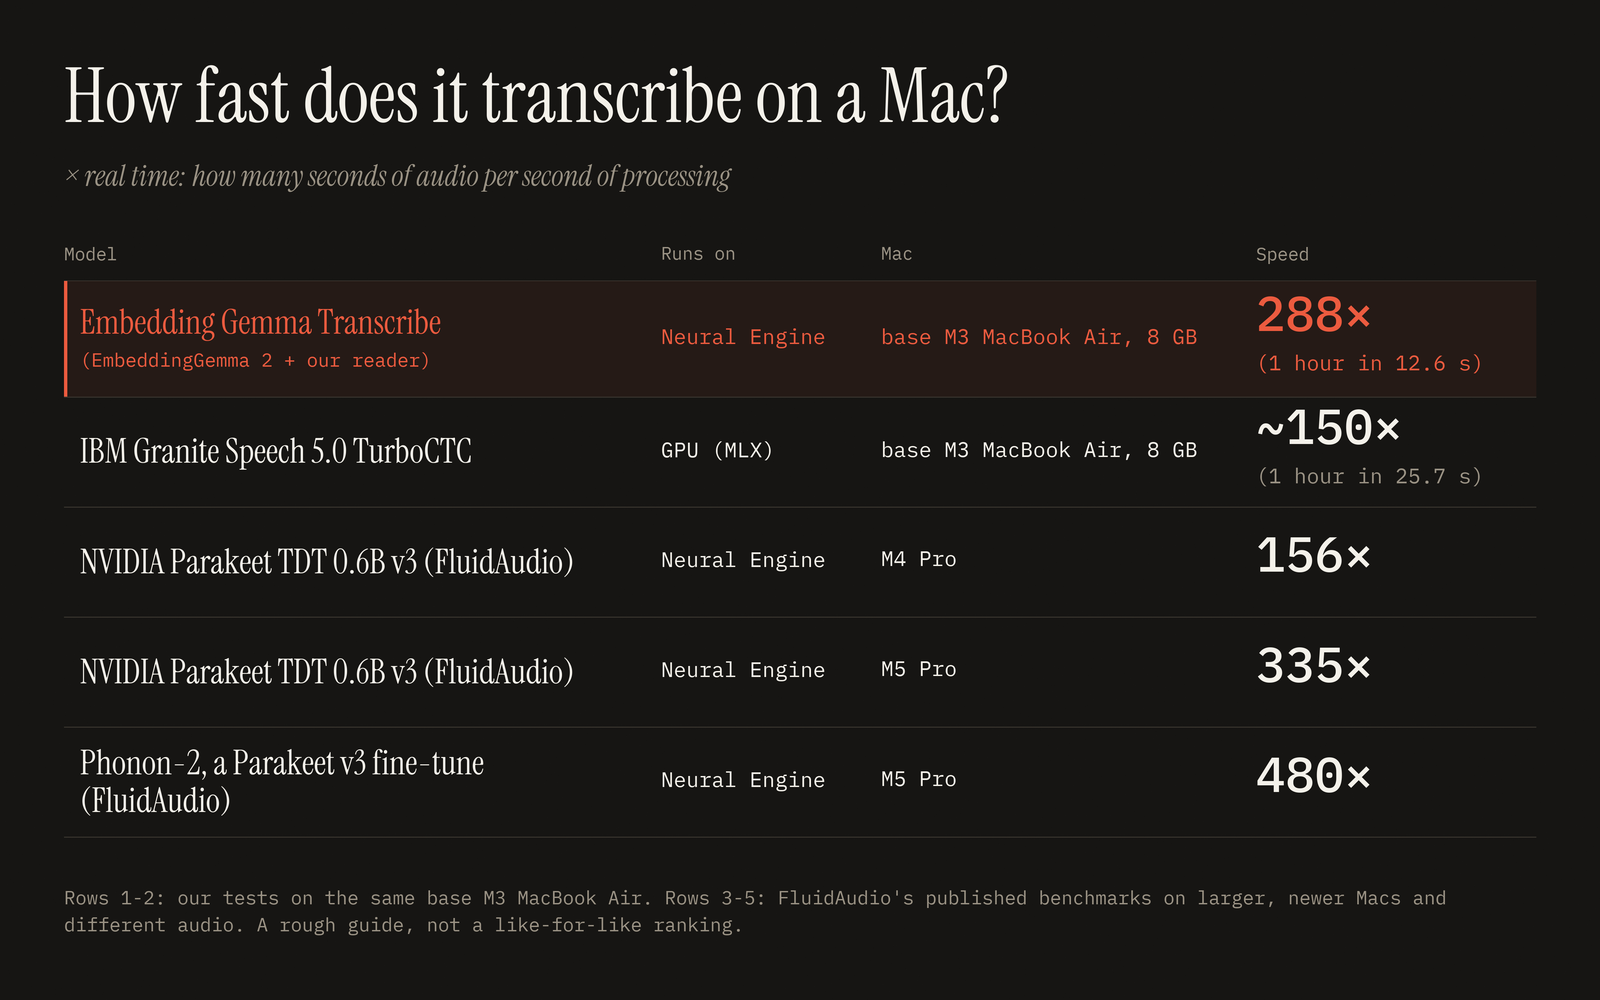
開発者ページの速度比較。1・2行目は同じ M3 MacBook Air での実測、3〜5行目は別条件の公開値で、単純な順位表ではない
精度については、速さほど派手ではない。Hugging Face のモデルカードでは、dev-clean の WER は 6.57%、test-clean は 6.81%、test-other は 15.10% とされている。開発者ページでは現在の WER は約 5% と説明されているが、評価条件や対象が完全に同じかははっきりしない。少なくとも、最先端の音声認識モデルが 2〜3% 台だという開発者側の比較はあるので、精度ではまだ差がある。
誤りの内訳も、この方式らしい。最頻の置換は機能語で、in と and のような入れ替えが目立つ。さらに、同音異義語は全置換の 12.4% を占める。言語モデルがない以上、音が似ていて文脈で見分けるタイプの誤りは残る。短い語は比較的強く、1〜2 トークン相当の単語では WER 2.8%、3〜5 トークンでは 3.4%、6 トークン以上では 9.7% まで悪化する。長い語ほど不利なのは、音声の切り分けがそのまま効いているからだろう。
語彙外の単語も弱い。語彙にないものは常に誤りになる。英語の朗読音声だけを対象にしているので、当然ながら日本語音声はまともに扱えない。GIGAZINE の実演でも、日本語の発話から英単語だけを拾うような結果だった。これは性能不足というより、設計上の前提に外れている。
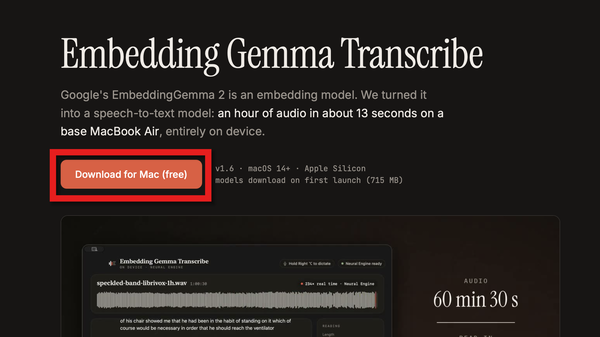
Embedding Gemma Transcribe の配布ページ(GIGAZINE の紹介記事より)
このモデルは、会議録を何でも雑に片付ける道具ではない。向いているのは、英語のきれいな読み上げ、特にオフラインで素早く文字にしたい場面だ。オーディオブック、朗読、発音が比較的整った音声。Hugging Face の説明でも、学習データは LibriSpeech train-clean-100 に限られている。公開朗読音声で鍛えたものを、雑音だらけの現場会話にそのまま持ち込むのは危ない。
一方で、完全に用途が狭いとも言い切れない。右 Option キーを押して話し、離すと他アプリへ入力できるという使い方は、短い英語入力ならかなり軽快そうだ。音声が端末外へ出ないのも強い。クラウド送信を避けたい人には、速度よりむしろこの性質の方が価値があるかもしれない。
自分なら、これは「第一選択の書き起こし器」ではなく、「英語音声の高速下書き器」として見る。会議記録の正本には向かないが、長い音声をまず荒く文字に落として、後で人が整える用途なら筋がいい。逆に、精度が少しでも重要な案件では、最初から通常の音声認識に任せる。
開発者ページでは、reader は音声エンコーダを凍結したまま、小さな層だけを学習している。訓練時間も 8×H100 で 2 時間未満と短い。ここから見えるのは、巨大モデルを再学習するより、「埋め込み空間をどう読むか」を詰める方が効く領域がある、ということだ。
ただ、改善の余地はそのまま限界でもある。言語モデルを足せば精度は上がるかもしれないが、その分この方式の軽さは削られる。語彙を増やせば未知語には強くなるが、最近傍探索のコストや曖昧さは増す。30 秒窓の重ね処理も、長文を扱うための現実的な妥協だ。速度を保ちながら精度を押し上げるには、どこかで別の代償を払うことになる。
だからこのモデルの面白さは、万能さではなく割り切りにある。埋め込みモデルは文字起こし専用ではない。それでも、音声がどの単語の近くに落ちるかを読むだけで、ここまで動く。しかも端末内で、かなり速く。用途を絞れば、これはかなり鋭い道具になる。
