この記事は後半です。前半は Qiita にあります: Qwen3.5の中にCPUを埋め込んだ話を、RAMの作り方からほどく
画像: divagr.com より
画像: divagr.com より
前半では、Qwen3.5-4B の前段に 32-bit RISC-V CPU を焼き込み、Gated DeltaNet の状態を RAM として使う、という骨格を見た。外部ツールは呼ばず、トークン列の流れの中で計算機が回る。ここで気になるのは、CPU と Qwen の役割分担が曖昧にならないのか、という点だ。
説明を追うと、境界はかなりはっきりしている。CPU 側は計算に必要な命令列を処理し、結果をトークンとして返す。Qwen 側はその出力を普通の文章として読み取り、続きの応答を作る。モデルの前にある 11 層の chip layer が命令の実行系で、その後ろの 32 層が通常の Qwen3.5 だ。つまり「LLM が賢くなって CPU を理解した」のではなく、LLM の手前に専用の計算層を置き、その層が自律的に動く構成になっている。
この構造の肝は、Qwen が tool-call っぽい形式で命令を書く点にある。見かけは外部ツール呼び出しに似ているが、実際には何も外に出ない。命令は重みの中にある CPU に渡り、実行結果だけが戻ってくる。言い換えると、これは「モデルが道具を使う」のではなく、「モデルの内部に道具が常駐している」状態だ。
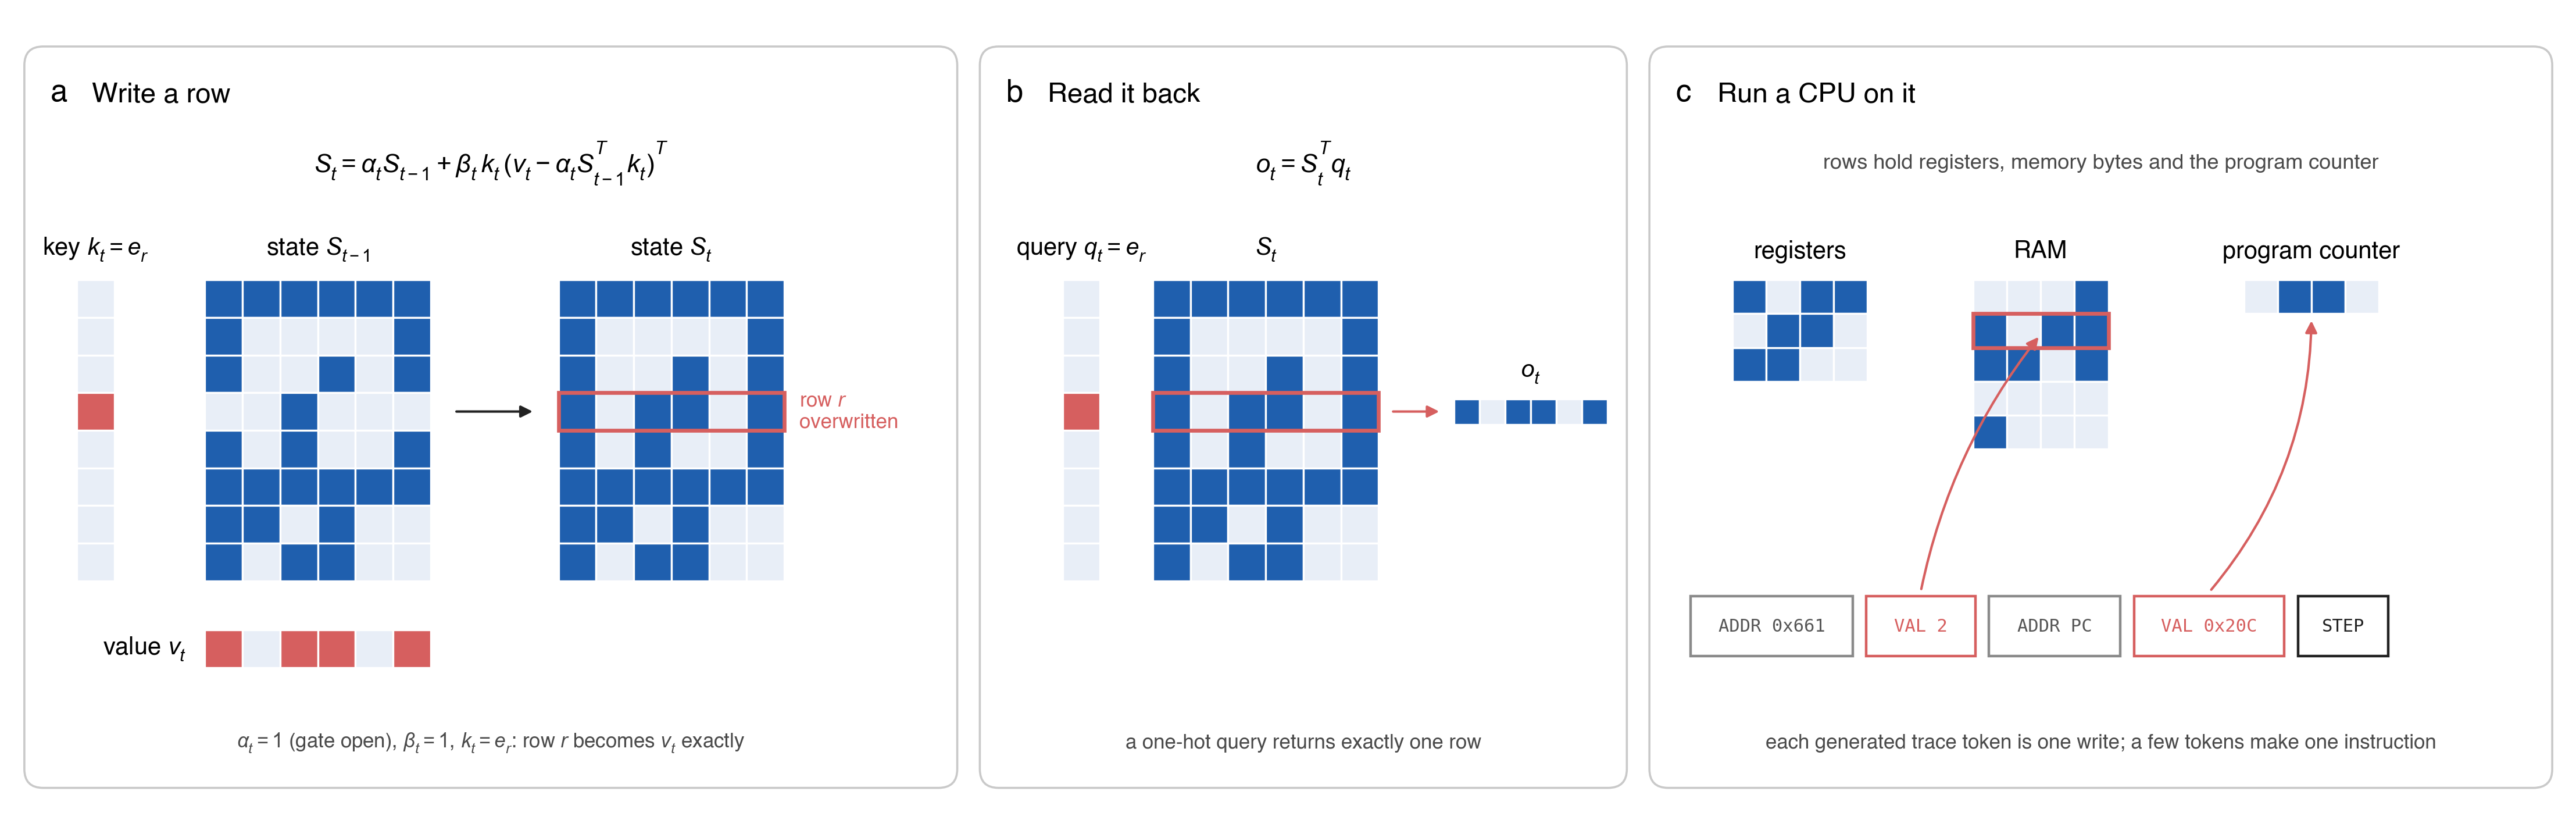
この仕組みがうまく動く理由は、Gated DeltaNet の状態を RAM として扱えるようにした点に尽きる。README では、ゲートを 1、書き込み強度を 1、one-hot key を使うと、各書き込みがちょうど 1 行だけを上書きし、one-hot query でその行をそのまま読む、と説明されている。ふつうの RNN なら、状態はぼやけて残る。だがここでは、行番号を指定して書き、行番号を指定して読む。これで記憶は曖昧な文脈ではなく、アドレス付きのメモリになる。
さらに、各行には 1 バイトをビットとして置き、低位のアドレスビットで head を選び、残りで行を選ぶ。レジスタ、プログラムカウンタ、コールスタックまで DeltaNet の状態に配置されるので、CPU に必要な「見失ってはいけない値」を全部その場で持てる。ここが、単なる fast weights の応用と違うところだ。線形 RNN の状態を記憶として使う研究自体は既にあるが、ここではそれを exact に、しかも実行可能な CPU の形に落としている。
もう一つ大事なのは、誤差が積もるような学習でこの RAM を作ったのではないことだ。コンパイラが各重みを直接計算し、回路として置いた。そのため、理屈の上では「毎回ちょっとずつ近似する」のではなく、最初から決め打ちの回路として振る舞う。exact さが必要な算術には、この作り方がよく効いている。
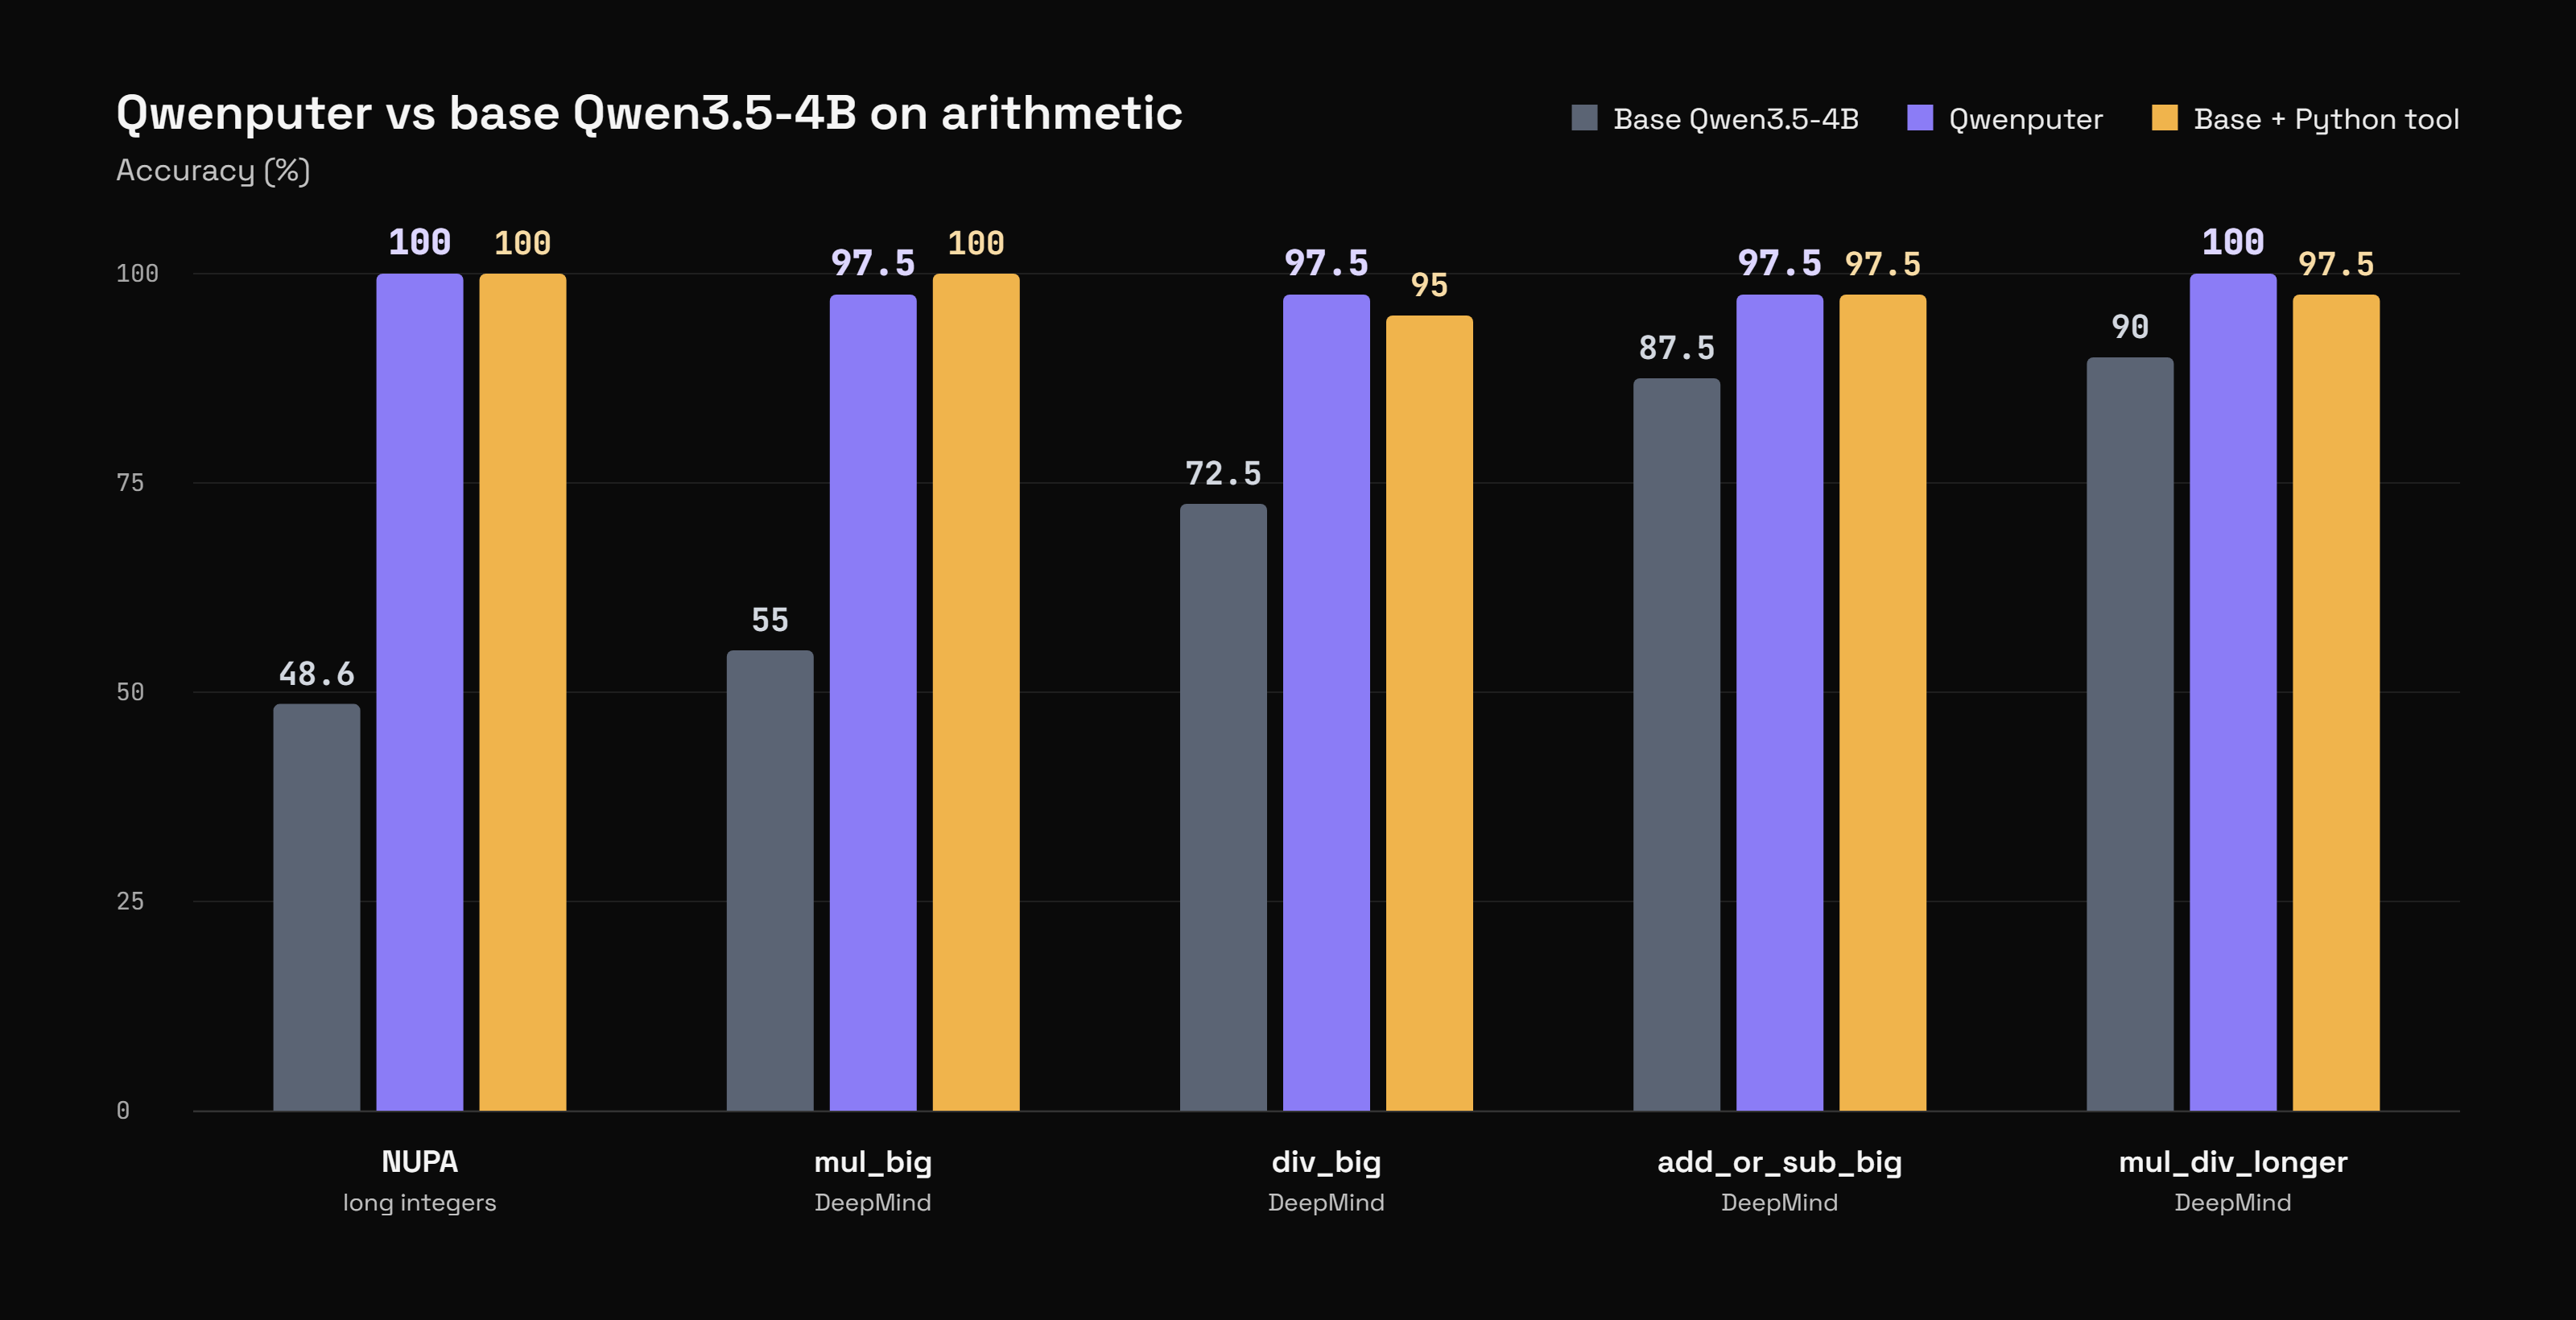
ベンチマークを見ると、強みははっきりしている。Synthetic integer arithmetic では base Qwen3.5-4B の 75.0 に対して Qwenputer は 97.5、DeepMind の mul_big は 55.0 から 97.5、div_big は 72.5 から 97.5 に伸びる。mul_div_multiple_longer は 100.0、add_or_sub_big は 97.5 だ。NUPA の長整数算術では 48.6% から 100% まで上がっている(ブログの記載。README では初代 CHIP-8 版の数字として載っている)。
ただし、これは万能ではない。README の初代 CHIP-8 版の説明でも、GSM8K や GSM-Hard は同程度で、算術そのものより言語的な推論が支配的な問題では伸びにくいとされている。逆に、長い式の連鎖(mixed_longer など)では base Qwen が上回る場面もあった(RISC-V 版の表では mul_div_multiple_longer は 100.0 まで上がっている)。モデルは一度得た exact な結果を再確認しがちで、トークン予算を食い潰すことがあるからだ。CPU が正しくても、Qwen 側の進め方が遅いと全体の解は鈍る。
もっと面白いのは、CPU 自体の出力が崩れていない点だ。約 230,000 個の出力位置を参照機械と突き合わせてミスマッチは 0 だった。テキスト側も base とほぼ同じで、KL は 6e-4、ノイズフロアは 5e-4。つまり、計算機を埋め込んだせいで雑談が壊れた、という形にはなっていない。
後半でもう一つ触れておきたいのが filesystem 版だ。これは experimental かつ進行中の扱いで、calc に加えて put、append、get、list、delete が入る。保存先はやはり DeltaNet の状態で、ファイル名を 1,024 スロットのディレクトリにハッシュし、本文は別の head に格納する。検索は 2〜3 ステップ程度で済み、最大 512 ファイル、約 53,000 トークンまで持てる。
この版の価値は、単なる永続化ではない。会話をまたいで状態を引き継げるので、前回のチャットにあった情報を外部メモリとして扱える。multi-session recall は 83.3、変更された事実の想起は 90.0 とされ、Python tool を使うベースを上回るか同等だ。ここでは、モデルが「覚えている」ように見えるのではなく、実際に内部状態を保存している。
この仕組みをそのまま実運用に入れる、というより、私は二つの用途で見る。ひとつは、算術や手続き処理の正確さをモデル内部に閉じ込めたいとき。外部ツールの呼び出し先に依存せず、同じ forward pass の中で完結するのは、再現性の面でかなり強い。もうひとつは、モデル内部に監査可能な記憶を置きたいときだ。filesystem 版は、その方向にかなり踏み込んでいる。
一方で、これを「LLM が CPU になった」と言い切るのは少し乱暴だ。CPU 部分は厳密でも、その上で文章を組み立てるのは依然として Qwen だし、長い推論や曖昧なタスクでは別の弱さが残る。強いのは、決めた形式の計算と保存だ。逆に、自由形式の知的作業を丸ごと置き換えるものではない。
それでも、この実験はかなり示唆的だ。学習で新しい能力をにじませるのではなく、既存の重み構造に計算機を埋める。しかも RAM までモデル内部の状態で賄う。Qwenputer が変えているのは「LLM に何を学ばせるか」ではなく、「LLM の中に何を部品として置けるか」だ。そこが、この話のいちばん新しいところだ。
